AWS Lambda — Le compute serverless qui change les règles du jeu (Partie 1)
- Published on
- Authors
- Name
- Sylvain BRUAS
- @sylvain_bruas
AWS Lambda a révolutionné la manière dont nous construisons des applications cloud. Plus besoin de provisionner des serveurs, de gérer des mises à jour d'OS ou de dimensionner des clusters. Vous écrivez du code, vous le déployez, et AWS s'occupe de tout le reste : scaling, haute disponibilité, monitoring, patching.
Lancé en 2014, Lambda est devenu le cœur de l'architecture serverless sur AWS. C'est aujourd'hui le service de compute le plus utilisé après Amazon Elastic Compute Cloud (EC2). Mais Lambda n'est pas une solution universelle — il excelle dans certains cas et peut être peu performant dans d'autres.
Cette première partie couvre les fondamentaux : le modèle d'exécution, le cycle de vie d'une invocation, la facturation, les cas d'usage où Lambda brille et ceux où il faut regarder ailleurs. La seconde partie passera à la pratique : optimisation des cold starts, patterns d'architecture et construction d'une API REST serverless complète.
Présentation du service
Qu'est-ce qu'AWS Lambda ?
AWS Lambda est un service de compute serverless qui exécute votre code en réponse à des événements. Vous ne gérez aucune infrastructure : pas de serveur, pas d'OS, pas de runtime à maintenir.
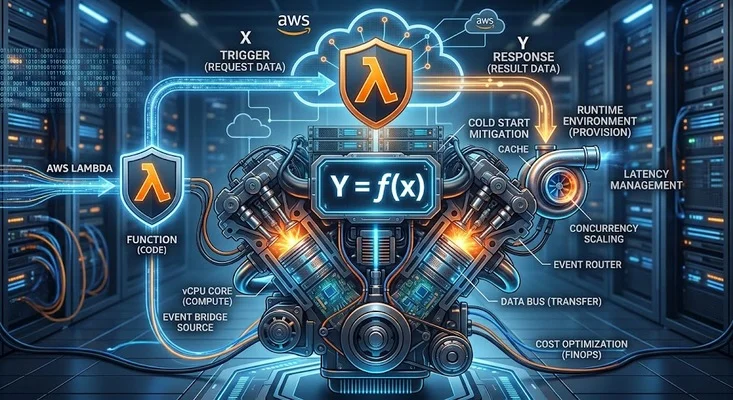
Une invocation suit toujours le même chemin : un événement arrive (dépôt de fichier, requête HTTP, message de queue), le service Lambda route la demande et gère le scaling, votre code s'exécute dans une micro-VM isolée propulsée par Firecracker, et la réponse repart vers l'appelant.
Caractéristiques techniques
| Caractéristique | Valeur |
|---|---|
| Mémoire | 128 Mo à 10 240 Mo (par incréments de 1 Mo) |
| CPU | Proportionnel à la mémoire (1 vCPU à 1 769 Mo, 6 vCPU à 10 Go) |
| Timeout | 1 seconde à 15 minutes |
| Taille du package | 50 Mo (zippé), 250 Mo (décompressé), 10 Go (container image) |
| Stockage éphémère | 512 Mo à 10 Go (/tmp) |
| Concurrence | 1 000 par défaut (extensible à des dizaines de milliers) |
| Langages natifs | Node.js, Python, Java, Go, .NET, Ruby |
| Custom runtimes | N'importe quel langage via Runtime API ou container images |
Le cycle de vie d'une invocation
Comprendre le cycle de vie est essentiel pour optimiser Lambda. Un cold start enchaîne quatre étapes avant même que votre handler ne démarre : téléchargement du code, création de la micro-VM, bootstrap du runtime, puis exécution du code d'initialisation. Un warm start ne fait que la dernière étape — il réutilise l'environnement déjà en place.
COLD START : download → micro-VM → bootstrap runtime → INIT → handler
WARM START : handler
Le INIT code (tout ce qui est en dehors du handler) n'est exécuté qu'une fois lors du cold start. C'est là que vous devez initialiser vos clients SDK, connexions DB et chargements de configuration.
Le modèle de facturation
Lambda facture sur deux axes : le nombre de requêtes (0,20 $ par million d'invocations) et la durée multipliée par la mémoire allouée (0,0000166667 $ par Go-seconde).
Formule : Coût = (invocations × 0,20$/M) + (durée_ms × mémoire_Go × 0,0000000167$)
Trois ordres de grandeur pour se repérer :
| Scénario | Coût mensuel |
|---|---|
| API : 10M req/mois, 200 ms, 512 Mo | ~22 $ |
| ETL : 1 000 exec/jour, 5 min, 3 Go | ~45 $ |
| Resize d'images : 100k/mois, 2 s, 1 Go | ~4 $ |
Le free tier inclut 1 million d'invocations et 400 000 Go-secondes par mois — suffisant pour beaucoup de projets personnels.
Cas d'usage
1. API REST et GraphQL serverless
L'architecture la plus courante : Amazon API Gateway (ou les Function URLs) devant Lambda, avec Amazon DynamoDB comme couche de persistance. Selon les besoins, Lambda peut aussi taper sur Amazon Simple Storage Service (S3) ou sur une base Amazon Relational Database Service (RDS) via RDS Proxy.
Pourquoi Lambda excelle ici :
- Scale automatiquement de 0 à des milliers de requêtes/seconde
- Pas de coût quand il n'y a pas de trafic (parfait pour les environnements de dev/staging)
- Chaque endpoint peut avoir sa propre Lambda avec sa propre mémoire et son propre timeout
- Couplé avec API Gateway : throttling, auth, caching et AWS Web Application Firewall (WAF) natifs
Pattern recommandé : une Lambda par route (ou par domaine fonctionnel) plutôt qu'un monolithe Lambda. Cela permet un scaling indépendant et des permissions granulaires.
2. Traitement événementiel (event-driven processing)
Lambda est nativement conçu pour réagir à des événements :
- S3 : un fichier est uploadé → traitement (resize, validation, indexation)
- DynamoDB Streams : un item change → propagation, dénormalisation, notification
- Amazon Simple Queue Service (SQS) : un message arrive → traitement asynchrone avec retry automatique
- Amazon EventBridge : un événement métier → orchestration cross-service
- Amazon Kinesis : un record arrive → traitement streaming en near real-time
- AWS IoT Core : un device envoie un message → ingestion et alerte
Un pipeline typique chaîne plusieurs de ces briques. Exemple pour du traitement de CV : l'upload dans S3 déclenche une première Lambda qui extrait le texte avec Amazon Textract, le résultat part dans une queue SQS, une seconde Lambda analyse le contenu avec Amazon Comprehend et écrit dans DynamoDB, puis un événement EventBridge déclenche la notification du candidat.
3. Tâches planifiées (CRON serverless)
Remplacez vos crontabs EC2 par EventBridge Scheduler + Lambda :
- Nettoyage quotidien de données expirées
- Rapport hebdomadaire envoyé par email
- Vérification de santé d'APIs tierces toutes les 5 minutes
- Rotation de credentials
- Synchronisation de données entre systèmes
Avantage vs cron sur EC2 : vous ne payez que le temps d'exécution (quelques secondes), pas un serveur 24/7 qui attend.
4. Backends mobiles et IoT
Lambda est idéal comme backend pour les applications mobiles et les objets connectés :
- AWS AppSync + Lambda : API GraphQL pour une app mobile
- IoT Core + Lambda : ingestion de données capteurs
- Amazon Cognito + Lambda triggers : personnalisation des flux d'authentification
- Amazon Simple Notification Service (SNS) + Lambda : push notifications conditionnelles
Le pattern serverless élimine le problème du « pic de Noël » — Lambda scale de 0 à 10 000 invocations concurrentes sans intervention.
5. Data transformation et ETL léger
Pour les transformations qui ne nécessitent pas un cluster Spark :
- S3 Object Lambda : transformer un objet à la lecture (masquer des PII, décompresser, filtrer)
- Kinesis + Lambda : enrichir un flux en temps réel
- AWS Glue triggers : post-traitement après un job Glue
- AWS Step Functions + Lambda : pipeline ETL avec retry et branching
Limite à connaître : le timeout de 15 minutes et la mémoire max de 10 Go bornent la taille des datasets traitables. Au-delà, passez à Glue ou à Amazon EMR Serverless.
6. Automation et DevOps
Lambda automatise les opérations cloud :
- Auto-remediation : une règle AWS Config non conforme → Lambda corrige automatiquement
- Custom Resources : étendre AWS CloudFormation avec votre logique
- AWS CodePipeline actions : étapes personnalisées dans un pipeline CI/CD
- Sauvegardes : snapshots planifiés, copie cross-account, purge des anciennes versions
- Cost optimization : stop/start d'instances EC2 hors heures ouvrées, suppression de ressources orphelines
7. Edge computing (Lambda@Edge et CloudFront Functions)
Exécuter du code au plus près des utilisateurs, sur le réseau Amazon CloudFront :
| Lambda@Edge | CloudFront Functions | |
|---|---|---|
| Cas d'usage | SSR partiel, A/B testing, auth, personnalisation | Redirections, URL rewriting, headers |
| Runtime | Node.js, Python | JavaScript (ES5.1) |
| Mémoire | 128 Mo - 3 Go | 2 Mo |
| Durée max | 30 s (origin) / 5 s (viewer) | 1 ms |
| Accès réseau | Oui | Non |
| Coût | ~0,60 $/M requêtes | ~0,10 $/M requêtes |
Quand NE PAS utiliser AWS Lambda
1. Workloads longue durée (> 15 minutes)
Le problème : Lambda a un timeout maximum de 15 minutes. Si votre traitement dépasse cette limite, il sera tué sans pitié.
Symptôme : vous découpez artificiellement un traitement de 2 heures en chaînes de Lambda avec Step Functions juste pour contourner le timeout.
Alternatives :
- AWS Batch : jobs de longue durée (minutes à jours)
- AWS Fargate : containers avec durée illimitée
- EMR Serverless : jobs Spark/Hive sans gestion de cluster
- Step Functions + Amazon Elastic Container Service (ECS) : orchestration de tâches longues
2. Applications avec état (stateful)
Le problème : chaque invocation Lambda est indépendante et potentiellement exécutée sur une VM différente. Vous ne pouvez pas compter sur un état en mémoire entre les invocations.
Symptôme : vous essayez de maintenir des WebSockets, des sessions in-memory ou un cache local qui doit persister entre les requêtes.
Alternatives :
- ECS / Amazon Elastic Kubernetes Service (EKS) : containers stateful avec volumes Amazon Elastic Block Store (EBS)
- Amazon ElastiCache : état partagé en Redis/Valkey
- API Gateway WebSocket + DynamoDB : WebSockets serverless avec état externalisé
3. Charges prévisibles et constantes (high throughput)
Le problème : si vous avez un flux constant de 10 000 requêtes/seconde 24/7, Lambda coûte significativement plus cher qu'un cluster ECS ou EC2 correctement dimensionné.
Pour 10 000 req/s à 200 ms et 1 Go de mémoire, on arrive à environ 26 milliards de Go-ms par mois :
| Option | Coût mensuel estimé |
|---|---|
| Lambda | ~432 $ (+ requêtes) |
| Fargate (4 tasks × 1 vCPU × 2 Go) | ~120 $ |
| EC2 (2× m6i.large, Reserved 1 an) | ~80 $ |
Règle : si votre Lambda est invoquée plus d'un million de fois par jour avec une durée supérieure à 500 ms, faites le calcul comparatif avec ECS ou EC2.
4. Applications qui nécessitent un GPU
Le problème : Lambda ne supporte pas les GPU. Point final.
Symptôme : vous voulez faire de l'inférence ML, du transcoding vidéo GPU-accéléré ou du rendering 3D.
Alternatives :
- Amazon SageMaker AI Endpoints : inférence ML avec GPU
- EC2 (instances G/P) : GPU à la demande
- AWS Batch avec GPU : jobs ML/rendering par lots
- Amazon Bedrock : inférence sur modèles fondamentaux, sans gérer le GPU
5. Latence garantie sous les 50 ms
Le problème : les cold starts ajoutent de la latence imprévisible. Comptez 100 à 300 ms pour Node.js et Python, 500 ms à 3 s pour Java et .NET, 1 à 5 s pour les container images.
Symptôme : votre SLA exige une latence P99 sous 50 ms et vous ne pouvez pas tolérer de cold starts occasionnels.
Mitigations possibles :
- Provisioned Concurrency : instances pré-chauffées (mais coûteux)
- SnapStart (Java, Python, .NET) : réduit fortement le cold start
- Architecture alternative : ECS/EKS avec un minimum de tâches toujours actives
6. Traitement de fichiers très volumineux en mémoire
Le problème : Lambda est limitée à 10 Go de mémoire et 10 Go de stockage éphémère (/tmp). Si vous devez charger un fichier de 50 Go en mémoire pour le traiter, Lambda n'est pas adapté.
Symptôme : OOM récurrents, /tmp plein, timeouts sur les gros fichiers.
Alternatives :
- Fargate (jusqu'à 120 Go de mémoire)
- EC2 (jusqu'à 24 To de RAM sur les instances u-*)
- EMR : traitement distribué de gros datasets
7. Monolithes applicatifs complexes
Le problème : migrer un monolithe Spring Boot de 500 Mo avec 200 endpoints vers une seule Lambda produit des cold starts de 10 à 30 secondes et des packages trop volumineux.
Symptôme : un package de déploiement de 250 Mo, des temps de cold start supérieurs à 10 s, une complexité de debug excessive.
Alternatives :
- ECS / EKS : gardez votre monolithe dans un container
- AWS App Runner : déployez un container sans gérer l'infra
- Refactoring progressif : extrayez les fonctions chaudes en Lambda individuelles
Ce qu'il faut retenir
Lambda est un excellent choix quand votre charge est événementielle, variable et courte. Il devient un mauvais choix dès que vous avez besoin de durée illimitée, d'état en mémoire, de GPU, ou d'un trafic constant et prévisible à très haut volume.
Le réflexe à garder : avant de choisir Lambda, posez trois questions. Le traitement tient-il en moins de 15 minutes ? Peut-il être totalement stateless ? Le trafic est-il variable ou intermittent ? Trois oui, et Lambda est probablement le bon outil.
Dans la seconde partie, nous passons à la pratique : optimisation des cold starts, patterns d'architecture éprouvés, et une API REST serverless complète en TypeScript avec API Gateway, DynamoDB et Terraform.